GPT-6 실무 활용 가이드 요약
GPT-6.1 Sol에 대한 사용 후기를 블로그에 남겨 보겠다. 한마디로 말하자면 가격 대비 충분한 역량을 갖췄지만 생성 속도가 아쉬웠다. 3D 작업에서 두세 차례 수정이 필요한 것은 GPT-6 Astra 와 비슷했다.
아키텍처와 스키마 설계, 계획 수립에는 GPT-6 Astra를 사용하고 구현에는 GPT-6.1 Sol을 사용하는 방식도 고려할 수 있다. 복잡한 설계 판단과 반복적인 구현 작업을 나눠 맡기는 것이다. 다만 이 조합이 항상 가장 효율적인지는 실제 작업의 난도와 수정 횟수, 사용량을 함께 확인해야 한다.
1. 그래프가 보여 주는 속도 차이
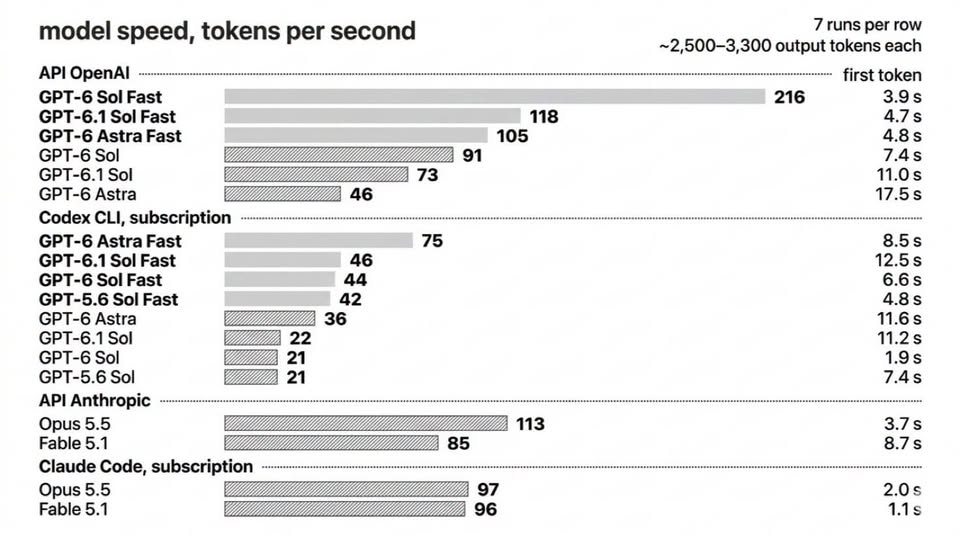
각 조건을 7회 실행하고, 실행마다 약 2,500~3,300개의 출력 토큰을 생성했다고 적혀 있다. 그래프의 Codex CLI 구독 환경 측정값은 다음과 같다.
| 실행 모드 | GPT-6.1 Sol 생성 속도 | Astra 생성 속도 | Sol 첫 토큰 대기시간 | Astra 첫 토큰 대기시간 |
|---|---|---|---|---|
| 일반 모드 | 22토큰/초 | 36토큰/초 | 11.2초 | 11.6초 |
| Fast 모드 | 46토큰/초 | 75토큰/초 | 12.5초 | 8.5초 |
이 측정에서 Astra의 출력 생성 속도는 같은 모드의 Sol보다 약 1.6배 높았다. 반면 일반 모드의 첫 토큰 대기시간은 거의 같았다. 따라서 일반 모드에서 나타난 Sol의 속도 차이는 응답을 시작하기까지의 대기보다 출력이 시작된 뒤 내용을 생성하는 과정에 있었다.
같은 양의 출력을 생성한다면 긴 응답일수록 이 차이가 커질 수 있다. 다만 생성 속도가 1.6배라는 이유로 전체 개발 작업도 1.6배 빨라진다고 해석할 수는 없다. 코드 탐색, 추론, 도구 실행, 테스트와 수정에 걸리는 시간이 별도로 있기 때문이다.
2. API에서는 결과가 달랐다
이 그래프에서 놓치지 말아야 할 부분은 API와 Codex CLI 구독 환경의 결과가 다르다는 점이다.
| API 실행 모드 | GPT-6.1 Sol | Astra |
|---|---|---|
| 일반 모드 | 73토큰/초 | 46토큰/초 |
| Fast 모드 | 118토큰/초 | 105토큰/초 |
API 측정에서는 오히려 Sol의 출력 생성 속도가 더 높았다. 따라서 이 자료를 근거로 “Sol은 Astra보다 항상 느리다”고 말하는 것은 정확하지 않다. “해당 측정의 Codex CLI 구독 환경에서는 Sol이 Astra보다 느렸다”고 표현해야 한다.
또한 이 그래프에는 측정 날짜, 프롬프트, 입력 길이, 추론 설정, 평균값인지 중앙값인지 등이 명시돼 있지 않다. 최초 작성자와 원본 게시물도 확인되지 않았다. 수치를 참고할 수는 있지만, 공식 성능 자료나 현재 속도를 보장하는 자료로 취급해서는 안 된다.
3. 5시간 제한은 총 작업시간 제한이 아니다
OpenAI 공식 문서에 따르면 Plus와 Standard Business에는 5시간 단위의 사용량 제한이 적용된다. 이는 누적 작업시간이 5시간에 도달하면 사용할 수 없다는 뜻이 아니다. 해당 시간 구간에 사용할 수 있는 사용량에 한도가 있다는 의미다.
Pro에는 현재 5시간 제한이 없다고 명시돼 있다. 그렇다고 사용량이 무제한이라는 뜻은 아니며, 주간 한도 등 다른 제한은 확인해야 한다. Enterprise와 Edu도 계약과 요금 방식에 따라 다르므로 기업용 전체를 제한의 예외로 묶을 수 없다.
Fast 모드의 사용량 소모도 고려해야 한다. 공식 문서상 구독에 포함된 사용량은 같은 모델의 일반 모드 대비 Fast 모드에서 2.5배 비율로 차감된다. 이 수치는 속도가 2.5배 빨라진다는 의미가 아니다.
4. 작은 작업 단위로 구현하고 검증하기
개발할 때는 전체 구조와 모듈 간 인터페이스를 먼저 정한 뒤, 작은 작업 단위로 구현과 검증을 반복하는 방식이 유용하다. 예를 들어 인증, 데이터 조회, 화면 표시를 각각 구현하고 확인하면 문제가 생겼을 때 원인을 좁히기 쉽다.
이러한 분할 정복(divide and conquer) 방식이 토큰 사용량을 반드시 줄여 주는 것은 아니다. 매번 같은 파일과 설명을 다시 전달하거나, 모듈 간 연결을 여러 차례 수정하면 사용량이 늘어날 수도 있다. 작업을 나누는 것과 함께 불필요한 문맥과 재작업을 줄여야 한다.
남은 사용량과 초기화 시점은 사용량 대시보드에서 확인할 수 있다. Codex CLI에서는 /status 명령으로 남은 한도를 확인할 수 있다. 한도에 도달했을 때는 초기화를 기다리는 방법 외에도, 지원되는 요금제에서 추가 크레딧을 구매하거나 API 키를 사용해 별도 과금으로 작업을 이어가는 방법이 있다.
모델을 비교할 때 가장 실용적인 기준은 정상 동작하는 결과를 얻기까지 걸린 총시간과 사용량이다. 생성 속도가 빠르더라도 수정이 반복되면 작업이 오래 걸릴 수 있다. 같은 작업을 맡기고 구현, 테스트, 오류 수정까지 포함해 비교해야 자신에게 맞는 모델과 작업 방식을 판단할 수 있다.
- 참고 자료: GPT‑6 제품군 모델 가이드
댓글남기기