arxiv-wiki
Difficulty Calibration Across Time for Membership Inference in Diffusion Models
- 게시일: 2026-10-31
- arXiv: 2610.40616v1 · PDF
- 저자: Michael Joseph, Yedid Hoshen
- 분야: cs.CV, cs.CR, cs.LG
- 선정 점수: 6.43
- 선정 이유: 최근성 0.7, 인용 영향 0.0 (인용 0회), 저자 영향 1.8 (최고 h-index 24), AI 주제 적합성 1.9, 개발자 관심 0.5, 학술 신호 0.3, 오픈 웨이트·주요 연구조직 신호 1.2
주요 Figure
원문 PDF에서 실제 Figure 캡션과 그림 영역이 함께 확인된 자료만 자동 추출했다.
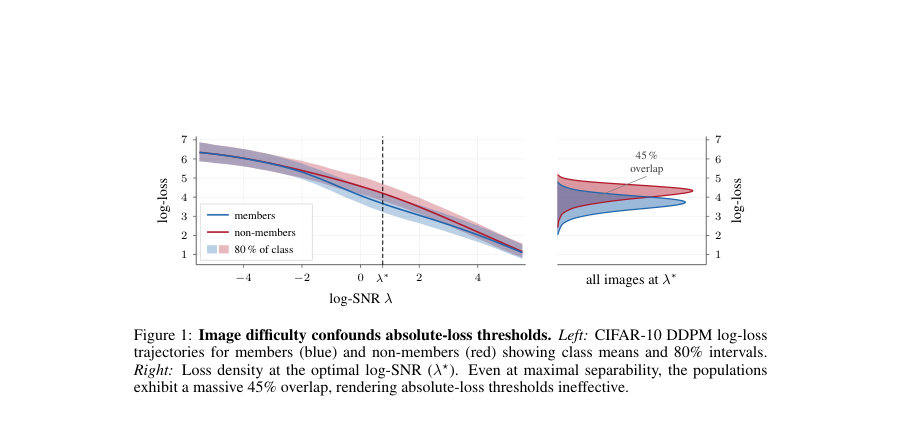
Figure · 원문 PDF 4쪽 · Figure 1: Image difficulty confounds absolute-loss thresholds. Left: CIFAR-10 DDPM log-loss
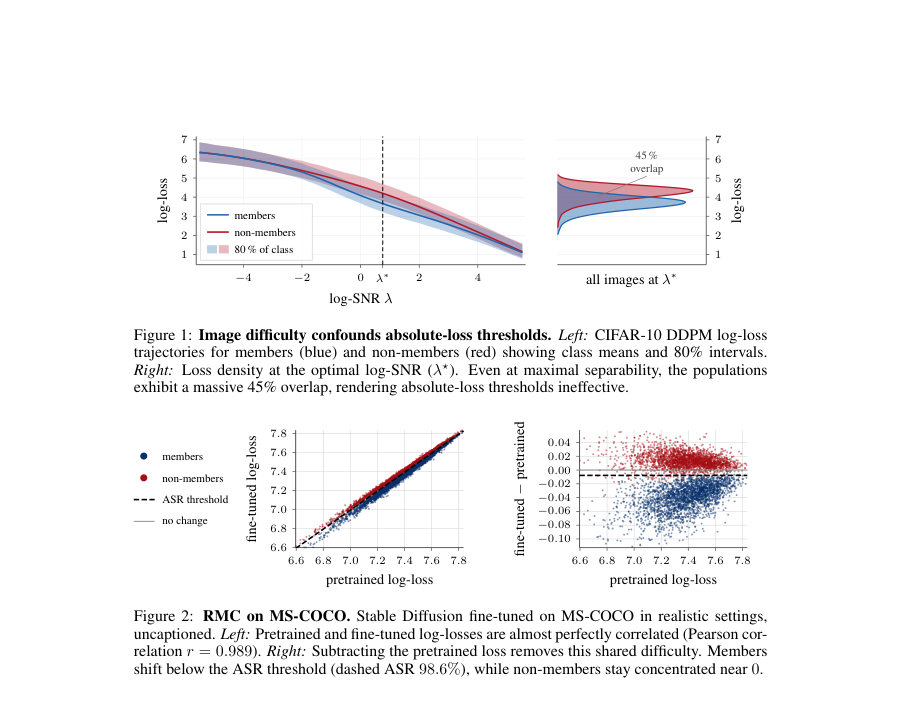
Figure · 원문 PDF 4쪽 · Figure 2: RMC on MS-COCO. Stable Diffusion fine-tuned on MS-COCO in realistic settings,
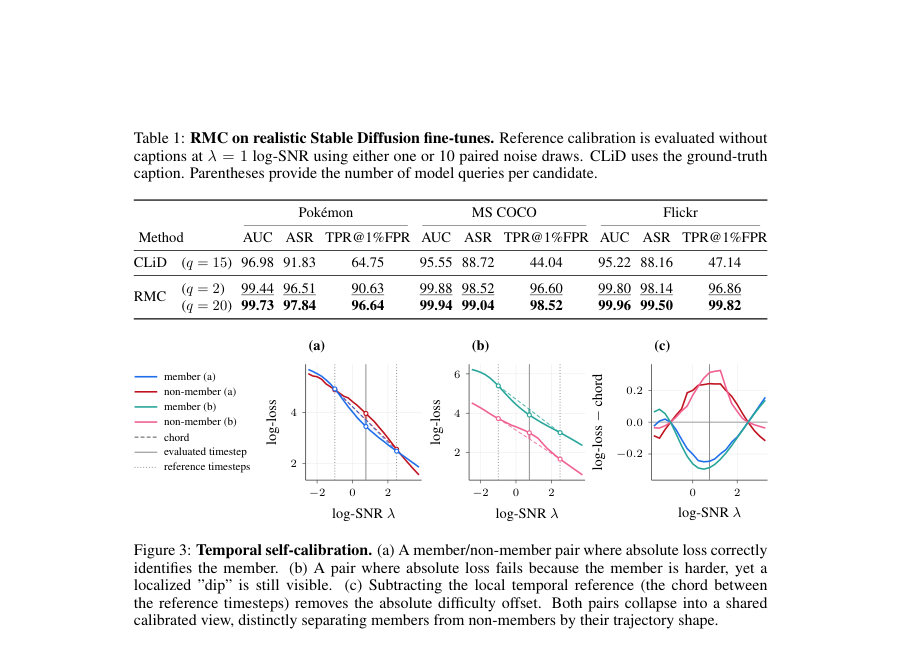
Figure · 원문 PDF 5쪽 · Figure 3: Temporal self-calibration. (a) A member/non-member pair where absolute loss correctly
한 문장 요약
확률적 디퓨전 모델의 멤버십 추론에서 이미지별 난이도(재구성 난이도)를 시간 축(학습 시간과 디퓨전 시간)을 따라 보정해, 난이도 요인으로 인한 오탐을 줄이고 멤버십 신호를 분리하는 두 가지 실용적 기법(RMC, TSC)을 제안한다.
해결하려는 문제
기존의 diffusion model 대상 멤버십 추론 공격은 개별 이미지의 절대 재구성 손실(Loss)을 낮게 보고 멤버로 판정하는 방식이 일반적이다. 그러나 일부 비학습(non-member) 이미지는 본질적으로 ‘쉽게’ 재구성되어 낮은 손실을 내고, 반대로 일부 학습(member) 이미지는 본질적으로 어렵게 재구성되어 높은 손실을 내므로, 손실의 절대값으로만 판정하면 난이도(difficulty) 요인이 멤버십 신호를 심각하게 혼동한다. 연구 질문은 이 난이도 혼동을 제거(또는 약화)하여 멤버십 신호만 뚜렷히 드러내는 실용적이고 범용적인 공격을 설계하는 것이다.
핵심 기여
- Temporal Self-Calibration (TSC)를 제안: 단일 모델의 서로 인접한 디퓨전(timestep / log-SNR) 손실을 이용해 중앙 시점의 로그손실과 양쪽 레퍼런스의 선형장(chord)을 빼서 이미지 난이도를 소거하고 멤버십 신호를 분리한다.
- Reference-Model Calibration (RMC)를 제안: 파인튜닝된 모델을 감사할 때 파인튜닝 이전(사전학습) 체크포인트의 동일 손실을 빼서 학습 시간 축으로 난이도 보정을 수행, 특히 소량 쿼리로도 높은 정확도를 달성함을 보임.
- 광범위한 실험적 검증: DDPM, DDPM++, Stable Diffusion v1.4 등 여러 모델 및 CIFAR-10/100, STL-10-U, Tiny ImageNet, Pokémon, MS-COCO, Flickr30k 데이터셋에서 기존 기준(NAIVE, SecMI, PIA, PIAN, CLiD 등)을 크게 상회하는 성능을 보고함.
- 모델 파라미터화(x/v/ϵ 예측)와 학습 손실(target loss)에 걸쳐 TSC의 강건성을 보이고, 멤버십 정보가 궤적상 어느 시점에 집중되는지(학습 목표에 따라 누가 더 유리한지) 분석함.
- 실험·해석적 진단: 로그 변환의 중요성, 대칭 참조(stencil) 선택, 창 폭(2Δ)·쿼리 예산(q)·참조 필터 등의 세부 설계 및 영향에 대한 정밀한 절차/절충 분석을 제공함.
접근 방법
- 핵심 아이디어
- 공통 전처리: 각 후보 이미지 x에 대해 모델 θ에서 여러 log-SNR(=λ) 위치에서의 재구성 제곱오차 Lθ(x,λ)을 측정하고 안정화를 위해 ℓθ(x,λ)=log(Lθ(x,λ)+δ) 를 사용(δ는 작은 안정화 상수, 본문에서는 1e-12 사용 사례가 언급됨).
- 1) Reference-Model Calibration (RMC)
- 상황: 감사 대상 모델 θ_FT가 사전학습 체크포인트 θ_pre에서 파인튜닝된 경우 사용.
- 점수: r_ref(x,λ) = ℓ_{θ_FT}(x,λ) − ℓ_{θ_pre}(x,λ).
- 해석: 파인튜닝 이전의 이미지별 난이도 기준을 빼서 파인튜닝으로 새로 ‘암기’된 항목만 남김.
- 매우 적은 쿼리(예: q=2, 각 모델에 하나씩)의 경우에도 강력함.
- 2) Temporal Self-Calibration (TSC)
- 상황: 사전체크포인트가 없을 때 단일 모델만으로 난이도 보정을 수행.
- 핵심 관찰: 이미지 난이도는 인접 noise-levels(λ 주변)에 대해 연속적으로 유지되는 반면, 멤버십으로 인한 이득(또는 누수)은 궤적의 특정 시간대에 집중되어 국소적 편차로 나타남.
- 연산: 중심 쿼리 지점 λ와 대칭 참조 λ−=λ−Δ, λ+=λ*+Δ를 정하고
- r_temp(x) = ℓθ(x,λ*) − 0.5(ℓθ(x,λ−) + ℓθ(x,λ+)).
- (세 점 대칭 스텐실; 계수 합이 0이므로 곱셈적 난이도 요인을 로그 도메인에서 상쇄)
- 하이퍼파라미터: 본문 실험은 윈도우 폭 2Δ=5 (즉 Δ=2.5)로 고정, DDPM 계열에 λ=0.75, Stable Diffusion 계열에 λ=0.25를 사용.
- 쿼리 예산 기본값은 q=15(각 점당 5개의 무작위 노이즈 드로우).
- 실험적 세부
- 로그손실 사용이 핵심(원시 손실 대비 성능 차이 큼).
- 참조 필터(끝점 대칭)가 다른 창 설계(가우시안, 중앙가중 등)보다 성능이 좋음.
- 대칭 참조는 윈도우의 비대칭(odd) 구성요소를 제거하여 불필요한 변동을 줄여 저FPR 운영에서 이득을 줌.
주요 결과
-
RMC (Stable Diffusion fine-tunes, uncaptioned): 표 1에서 RMC(q=2) — Poke9mon AUC 99.44, ASR 96.51, TPR@1%FPR 90.63; MS-COCO AUC 99.88, ASR 98.52, TPR@1%FPR 96.60; Flickr AUC 99.80, ASR 98.14, TPR@1%FPR 96.86. (CLiD 대비 대폭 우위; q=2의 저쿼리로도 성능 우수)
- TSC (DDPM benchmarks, Table 2): CIFAR-10: AUC 95.91, ASR 90.15, TPR@1%FPR 62.31 (기존 최강 기준 PIAN의 TPR@1%FPR 30.90 대비 약 2배). Tiny ImageNet AUC 78.63, TPR@1%FPR 12.27; STL-10-U AUC 77.84, TPR@1%FPR 9.57.
- TSC (Stable Diffusion uncaptioned, Table 3): Poke9mon AUC 91.37, TPR@1%FPR 55.77; MS-COCO AUC 85.55, TPR@1%FPR 29.16; Flickr AUC 84.60, TPR@1%FPR 30.28. (일부 경우 PIA가 Poke9mon에서 우세하나 보편적 강건성 보임)
- 강건성 across parameterizations (Table 4): CIFAR-100 DDPM++ (no augmentation)에서 TSC는 모든 (prediction head p ∈{x,v,ε}, loss target s ∈{x,v,ε}) 조합에서 최상이며 예: ϵ-loss 계열에서 TPR@1%FPR = 91.22–93.22%, v-loss 계열 80.56–81.31%, x-loss 계열 28.74–31.26%.
- 설계·약화 실험: 로그 변환이 중요 — Fig.5에서 로그손실 사용 TSC는 raw-loss TSC보다 훨씬 우수(예: TPR@1%FPR 거의 26% 대 raw 감소). 참조 필터·대칭성 실험(Table 5,6)에서 끝점 대칭(Δ=2.5,k=1)이 평균 AUC와 저FPR 성능에서 우수함. 쿼리 수(q)를 늘릴수록 성능 증가함(재현성: q=15 기본, q=45 더 향상).
한계
- 저자가 명시한 한계: (1) 제안 기법들은 후보 이미지에 대해 모델의 중간 denoising 출력(여러 noise levels의 예측/손실)에 접근해야 하며, 일부 배포된 API는 최종 생성물만 반환해 중간 상태 접근이 불가능할 수 있다. (2) RMC는 파인튜닝의 출발점인 사전학습 체크포인트에 접근 가능해야만 적용 가능하므로 실무에서 체크포인트가 없으면 사용할 수 없다. (3) RMC는 파인튜닝 전(pretraining) 코퍼스에 대한 멤버십을 별도로 식별하지는 않음 — 즉, RMC가 감지한 잔차는 파인튜닝 단계에서 새로 암기된 항목에 대한 증거지만 사전학습 데이터의 멤버십은 구분하지 못함.
- 본 논문 본문에서 합리적으로 확인되는 추가 제약(저자가 직접 다루지 않은 점과 실험 범위로부터 도출): (4) TSC의 하이퍼파라미터(λ*, Δ, q 등)는 섀도우 데이터로 튜닝되며, 섀도우 데이터가 현실적으로 준비되지 않거나 분포가 다른 경우 최적 지점 선택이 어려울 수 있다. (5) 실험은 DDPM, DDPM++ 및 Stable Diffusion v1.4에 집중되어 있어 다른 최신 아키텍처·API·압축·양자화 환경에서의 일반화는 추가 검증 필요. (6) 공격 비용: TSC 기본 q=15(각 후보에 대해 여러 노이즈 드로우·여러 타임스텝을 요청)로 대량 감사 시 계산·쿼리 비용이 실질적임.
개발자 관점
- 재현(핵심 구현 포인트): 로그 손실 ℓ=log(L+δ)을 사용하라(본문은 δ≈1e-12 예시). TSC는 세 점 대칭 스텐실 r_temp = ℓ(λ) − 0.5(ℓ(λ−Δ)+ℓ(λ+Δ))를 계산한다. 기본 권장값: 2Δ=5 (즉 Δ=2.5), q=15 (각 점당 5 draws), DDPM에서는 λ=0.75, Stable Diffusion에서는 λ*=0.25. 요청한 log-SNR(λ)을 모델의 내부 timestep에 nearest mapping해야 함(본문에서 이 매핑을 수행함).
- 데이터·하이퍼파라미터 튜닝: λ와 Δ는 훈련 목표(예: x/v/ε loss)에 따라 최적 위치가 이동하므로 섀도우 모델(또는 검증셋)을 사용해 λ를 찾을 것. 논문은 섀도우 셋으로 AUC 최적화를 통해 λ* 선정함.
- 쿼리·비용 절충: RMC는(사전체크포인트가 있다면) 매우 적은 쿼리(예: q=2)로도 우수하므로 실전에서는 우선 체크포인트 확보를 고려하라. 체크포인트가 없을 때는 TSC(q=15)로 보정. 대량 감사 시 q를 늘리면 성능 증가하지만 쿼리·계산 비용이 늘어남.
- 실행상 제약: 공격자는 모델이 요청 시 지정된 노이즈 레벨(혹은 log-SNR)에 대한 중간 예측(또는 해당 손실 값)을 반환해야 함. 공개 API에서 중간 스테이트를 제공하지 않으면 엔드투엔드 공격(혹은 역전기법)으로는 적용이 어려움.
- 안전·윤리 고려: RMC/TSC는 저FPR에서 강력하기 때문에 악용 위험이 있으므로 합법적·승인된 감사 시나리오에서만 사용해야 함. 감사 결과는 통계적 증거이며(특히 low-FPR·TPR tradeoff 존재), 단일 결과로 법적 결론을 내리지 말 것.
근거 범위: 이 분석은 제공된 논문 PDF 본문 전체(본문, 표, 부록 포함)에 근거해 작성되었다. 수치는 본문 표와 그림에서 직접 발췌하였다. 구현상 세부(예: 정확한 δ 값, 모델 내부 timestep 매핑 세부)는 본문·부록에 제시된 값(예: δ ~ 1e-12, 45 레벨 그리드 등)을 따랐으며, 실제 배포 API의 접근 제한이나 다른 아키텍처에서의 동작은 논문 실험 범위를 넘어 추가 검증이 필요하다.