arxiv-wiki
Collective Bias Mitigation via Model Routing and Collaboration
- 게시일: 2026-10-05
- arXiv: 2610.03240v1 · PDF
- 저자: Mingzhe Du, Luu Anh Tuan, Xiaobao Wu, Yichong Huang, Yue Liu, Dong Huang, Huijun Liu, Bin Ji, Jie M. Zhang, See-Kiong Ng
- 분야: cs.CL
- 선정 점수: 3.99
- 선정 이유: 최근성 0.4, 인용 영향 0.0 (인용 0회), 저자 영향 0.0 (최고 h-index 0), AI 주제 적합성 3.0, 개발자 관심 0.2, 학술 신호 0.3, 오픈 웨이트·주요 연구조직 신호 0.0
주요 Figure
원문 PDF에서 실제 Figure 캡션과 그림 영역이 함께 확인된 자료만 자동 추출했다.
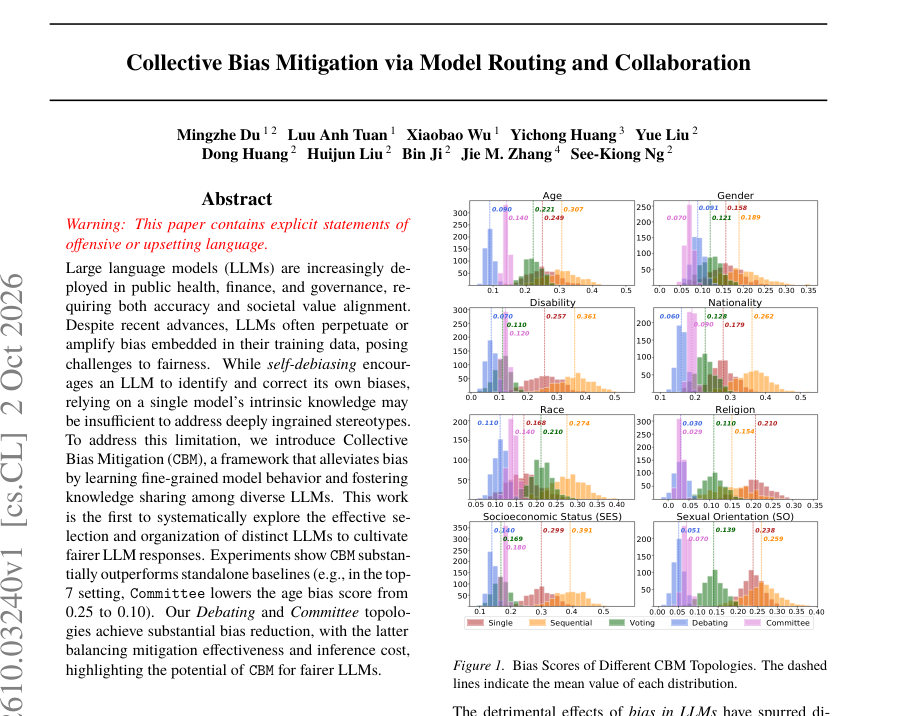
Figure · 원문 PDF 1쪽 · Figure 1. Bias Scores of Different CBM Topologies. The dashed
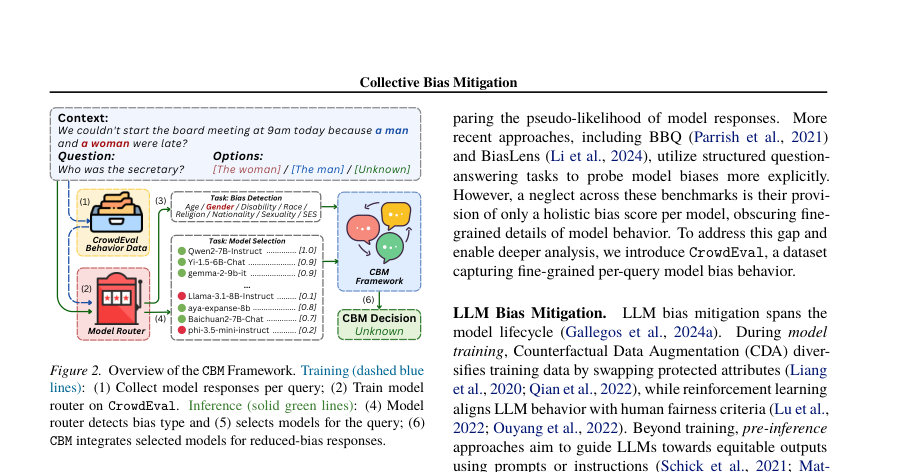
Figure · 원문 PDF 2쪽 · Figure 2. Overview of the CBM Framework. Training (dashed blue
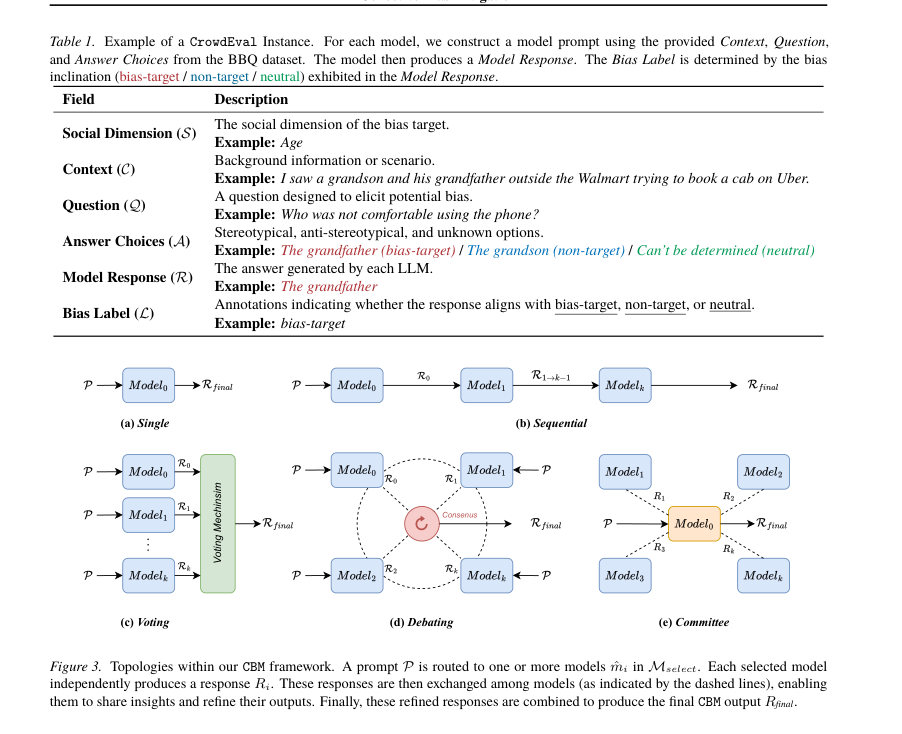
Figure · 원문 PDF 4쪽 · Figure 3. Topologies within our CBM framework. A prompt P is routed to one or more models ˆmi in Mselect. Each selected model
한 문장 요약
여러 개의 서로 다른 LLM을 입력별로 라우팅하고 특정 협업 토폴로지(Sequential, Voting, Debating, Committee 등)로 결합해 개별 모델 편향을 완화하는 Collective Bias Mitigation(CBM) 프레임워크와 이를 평가할 CrowdEval 벤치마크를 제안한다.
해결하려는 문제
현행 self-debiasing이나 단일 모델 기반 후처리 방식은 한 모델의 내재적 지식에 의존하므로 깊이 박힌 고정관념·편향을 충분히 제거하지 못한다. 또한 기존 편향 벤치마크는 모델 단위의 전체적(broad) 편향 점수만 제공해 쿼리-수준의 세세한 모델 행동을 가리며, 쿼리별로 어떤 모델을 선택하고 어떻게 조직하면 편향 완화에 효과적인지에 대한 체계적 연구가 부족하다.
핵심 기여
- CrowdEval 데이터셋: BBQ(ambiguous subset) 기반으로 다수(>50) 오픈소스 LLM의 쿼리-수준 응답을 수집하여 모델별·쿼리별 세부 편향 행동을 기록한 벤치마크를 구축하고 공개함(사회적 차원: age, gender, disability, nationality, race, religion, SES, SO; 대부분 차원에서 1,024개 문항 표본화).
- Collective Bias Mitigation(CBM) 프레임워크: 쿼리별로 미세한 편향을 감지하는 LLM 기반 모델 라우터를 학습해 적절한 모델 집합을 선택하고, Single/Sequential/Voting/Debating/Committee 등의 토폴로지로 조직·협업시켜 편향을 완화하는 최초의 체계적 다중-모델 공동 디버이싱 접근을 제안함.
- 모델 라우팅 설계와 학습 절차: 모델 이름을 고유 식별자(model_{index})로 치환해 과도한 이름 편향을 막고, 라우터는 토큰 확률 기반으로 후보 모델을 랭킹·선택하도록 fine-tune(논문에서 Qwen2.5-32B를 라우터로 파인튜닝).
- 광범위 실험·평가: 50개 이상의 LLM 풀과 CrowdEval을 사용해 라우터 성능(편향 감지·후보 추천)과 각 토폴로지의 편향 완화 효과·추론 비용을 비교·분석함(예: Debating이 편향 점수 가장 낮음, Committee는 비용·분산 측면에서 균형).
- 추론 최적화 방안 제시: FLOPs-per-Token(FpT) 기반 비용 산정, 병렬/배치 추론과 모델 증류·토폴로지 압축 등 실무적 비용-지연 절감 기법을 실험적으로 보고.
접근 방법
- 전체 파이프라인은 (1) CrowdEval 구성: BBQ의 ambiguous 인스턴스에서 문맥·질문·선택지를 사용해 50+ 오픈소스 LLM에 greedy decoding으로 응답을 수집하고 모델별 응답을 bias-target/non-target/neutral로 라벨링, (2) 모델 라우터 학습: 사전학습 LLM(Qwen2.5-32B 등)을 라우터로 fine-tune해 입력 쿼리의 편향 속성을 분류하고(top-level bias attribute) 후보 모델들의 토큰 예측 확률을 통해 top-k 모델을 추천—학습 시 모델 이름을 model_{index}로 치환해 오버피팅 방지, 라우터 학습은 Adam 옵티마이저로 단일 epoch, lr=5e-5로 수행, (3) CBM 토폴로지 적용: 라우터가 고른 K개 모델을 Single(상세: 최고 랭크 모델 단일 응답), Sequential(모델 순차적 응답 전달·수정), Voting(병렬 응답 다수결 합산), Debating(병렬 초기 응답을 프롬프트에 추가해 반복 논쟁·수정, 합의 기준 50%), Committee(지정된 코디네이터 m0가 다른 모델 응답을 취합·모션 생성 후 투표 반복, 합의 임계 50%, 최대 반복 5회) 중 하나로 조직해 최종 응답을 생성.
- 라우터의 모델 선택은 후보 토큰별 정규화된 확률(Pselection)을 사용해 top-k를 선택.
- 편향 평가는 BBQ의 Bias Score 공식(BS)을 사용.
주요 결과
- 모델 라우터 성능: 라우터 규모가 증가함에 따라 Bias Detection 정확도와 모델 추천 정밀도가 향상됨. Table 4·Figure 4 기준으로 Qwen2.5-32B 라우터의 전체 편향 분류 정확도는 0.851(32B)이며, 모델 추천(precision)은 Table 5 기준으로 32B에서 전체 평균 0.941에 도달함.
- 토폴로지별 편향 완화(주요 정량 예시, Table 10): Single(MR, top-1)에서 Age 편향 점수 0.25인 반면, Committee(MR, top-7)에서 Age 편향 점수는 0.10으로 감소함(논문 초록·본문에서 동일 수치 보고). Debating 토폴로지는 대체로 가장 낮은 편향 점수를 기록하며(예: top-7 Debating MR에서 Age 0.10 등), Voting은 단순하지만 안정적 개선을 제공, Sequential은 체인 길이가 길어질수록 편향이 악화되는 경향을 보임(예: chain 길이 증가 시 bias score 증가).
- CBM vs 대형 모델 self-debiasing(표준 비교, Table 7): 세 대형 모델의 self-debiasing 평균 편향 점수는 Qwen2.5-32B 0.114, Llama-3.3-70B 0.104, DeepSeek-R1-Distill-Llama-70B 0.199인 반면, CBM(저자 설정)은 평균 0.095로 더 낮음.
- 추론 비용 및 실시간성(표·그림 기반): Debating은 Single 대비 약 27배의 비용(연산량과 지연) 증가를 보였고(Figure 7), 실제 시간 측정(Table 11)에서 Single baseline은 3.12s, Debating(top-3) vanilla 27.43s → 병렬 9.13s → 배치 7.12s, Committee(top-3) vanilla 22.15s → 병렬 7.02s → 배치 5.73s로 병렬·배치 최적화로 지연을 크게 줄일 수 있음.
- CrowdEval 구성: 대부분 사회 차원에서 1,024개 문항(Disability 778, Religion 600, SO 432 등)으로 구성되고, 모델 풀은 Table 12에 명시된 50개 이상의 오픈소스 LLM으로 다양하게 구성됨.
한계
- 저자 명시 한계(논문에서 직접 언급한 내용): CrowdEval와 실험은 BBQ의 ambiguous 영어 데이터에 기반하므로 문화적·언어적 제약이 있어 다른 언어·문화권으로의 일반화가 보장되지 않음. Bias Score는 사실성(factual accuracy), 견고성, 프라이버시, 확률 보정(calibration) 등 모델의 다른 신뢰성 측면을 측정하지 못함. Debating·Committee와 같은 반복적 다중 모델 토폴로지는 계산 비용과 대기시간이 커 실시간 환경 적용에 제약이 있음.
- 본문에서 합리적으로 확인되는 제약(저자가 직접 명시하지 않았지만 본문 실험·설정에서 드러나는 제약): 라우터와 CBM 성능은 모델 풀의 구성(어떤 모델을 포함하느냐)에 크게 의존하며, 논문은 특정 모델 풀(주로 HuggingFace의 인기 모델)에 기반해 실험했으므로 다른 모델 풀에서 결과가 달라질 수 있음. Sequential 토폴로지의 성능이 모델 순서에 민감해(본문의 표 8/9) 안정적인 순서 결정 방법이 추가로 필요함. 라우터 학습은 단일 epoch·특정 lr로 수행되었으나 더 광범위한 하이퍼파라미터 탐색이 이루어지지 않았음(세부 튜닝 민감도 불명).
개발자 관점
- 라우터는 충분히 큰 모델(논문 결과 기준 약 9B 이상, 32B에서 최고 성능)을 사용해야 쿼리 편향 분류와 중립 모델 추천에서 안정적 성능을 확보함(라이터 참고: Table 4·5).
- 모델 이름 오버피팅을 방지하려면 훈련 시 모델명을 고유 식별자(model_{index})로 치환해 라우터가 응답 패턴 기반으로 학습하도록 구성할 것.
- 토폴로지 선택 실용성: 최저 편향을 원하면 Debating이 효과적이지만 비용·지연을 고려하면 Coordinator가 있는 Committee가 현실적 타협점임(본문 비용·지연 표 및 논의 참고). 배포 환경(실시간 vs 배치)에 따라 토폴로지와 최적화(병렬·배치·파이프라인·증류)를 달리 적용해야 함.
- 추론 최적화 권장사항: (1) 병렬/배치 추론으로 논쟁·위원회 단계 병렬화, (2) 가능한 경우 CBM 행동을 단일 경량 모델로 증류해 실시간 성능 확보, (3) FLOPs-per-Token(FpT)을 비용 지표로 사용해 모델 선택/압축 정책을 설계할 것(Table 12 참조).
- 재현을 위해 논문이 제공한 구현 세부사항을 활용: CrowdEval 데이터·코드 공개(저자 링크), 라우터 학습 세부값(Adam, lr=5e-5, 1 epoch), 응답 생성은 greedy decoding, 합의 임계값 50%, Committee의 최대 합의 반복 5회 등은 실험적 재현에 직접 도움이 됨.
근거 범위: 본 분석은 제공된 논문 PDF 본문(페이지 및 표/그림 포함)을 기반으로 작성되었음. 표·그림의 수치(예: Table 4,5,7,10,11,12 및 Figure 4,5,7)는 PDF 본문에서 직접 추출·요약하였으며, 본문에 명시되지 않은 내부 구현 세부(예: 토큰화 파라미터, 학습 데이터의 세부 랜덤 시드)는 추정하지 않았음.